Fra skakmotor til LLM-agent
AI-agenter: 22 spørgsmål og svar
Hvordan begrebet agent har udviklet sig fra 1912 til i dag, hvad der faktisk er nyt, hvor hurtigt det går — og hvilke dilemmaer autonomi skaber. Alle svar har kilder nederst.
Siden bygger på mit oplæg om samme emne. Klik på et spørgsmål for at læse svaret.
 1 · Hvad er en agent?
Definition, bestanddele og et lille eksempel.
Hvad gør noget til en agent — og ikke bare et program?
En agent observerer sit miljø og handler for at nå et mål. Det afgørende er løkken: efter hvert skridt vurderer den selv, om målet er nået. Er det nået, leverer den resultatet. Er det ikke nået, vælger den næste skridt ud fra resultatet af det forrige.
Det er selvstændigheden i vejvalget — ikke intelligensen — der gør den til en agent. Rammerne bestemmer, hvor langt den må gå.
Træk diagrammet til siden for at se det hele.
Hvilke dele består en AI-agent af?
 Model
- Sprogmodellen, der ræsonnerer og vælger næste skridt.
 Instruktioner
- Systemprompt og opgave: rolle, mål og regler.
 Værktøjer
- Funktioner med navn, beskrivelse og inputformat.
 Løkken
- Koden, der kalder modellen, kører værktøjer og sender svar tilbage.
 Hukommelse
- Samtalehistorik i konteksten og eventuelt lager mellem opgaver.
 Rammer
- Rettigheder, sandkasse, stopbetingelser og godkendelse.
Hvor meget af en agent er egentlig ny teknologi?
Kun modellen. Løkken, værktøjerne, rettighederne og logningen er almindelig software.
Det er godt nyt, for det er netop i den almindelige software, man styrer agenten. Pålidelighed kommer ikke fra en bedre model alene, men fra at rammerne er bygget rigtigt.
Hvad stopper en agent?
Rammerne gør. En agent stopper, når målet er nået — men også ved et maksimalt antal gennemløb af løkken, ved en fejl eller ved et krav om menneskelig godkendelse før en bestemt handling.
Uden eksplicitte stopbetingelser kan en agent blive ved. Det er en af de billigste sikkerhedsforanstaltninger, man kan bygge ind.
Hvordan ser en simpel agent ud i praksis?
Tag en lille driftsagent. Opskriften er den samme hver gang:
- Beskriv et værktøj for modellen — en almindelig funktion med navn, beskrivelse og inputformat.
- Giv målet i almindeligt sprog.
- Sæt en stopbetingelse, for eksempel højst ti gennemløb af løkken.
- Lad løkken køre: modellen vælger et værktøj eller svarer.
- Kør værktøjet og send resultatet tilbage til modellen.
- Når modellen ikke beder om flere værktøjer, er målet nået, og den leverer svaret.
import anthropic, requests
client = anthropic.Anthropic()

# 1 · Værktøjet: en helt almindelig funktion
def hent_status(url):
    try: return str(requests.get(url, timeout=5).status_code)
    except Exception as e: return f"Fejl: {e}"

# ... beskrevet for modellen: navn, forklaring, inputformat
tools = [{"name": "hent_status",
          "description": "Henter HTTP-status for en URL",
          "input_schema": {"type": "object", "required": ["url"],
            "properties": {"url": {"type": "string"}}}}]

# 2 · Målet, i almindeligt sprog
messages = [{"role": "user",
             "content": "Tjek om https://example.dk svarer."}]

# 3 · Stopbetingelsen: højst 10 gennemløb af løkken
for skridt in range(10):
    # 4 · Beslut: modellen vælger et værktøj eller svarer
    svar = client.messages.create(model="claude-opus-5",
        max_tokens=1024, tools=tools, messages=messages)
    messages.append({"role": "assistant", "content": svar.content})

    # 5 · Mål nået: den beder ikke om flere værktøjer
    if svar.stop_reason != "tool_use":
        print(svar.content[0].text)
        break

    # 6 · Handl og observér: kør værktøjet, send resultatet tilbage
    resultater = [{"type": "tool_result", "tool_use_id": b.id,
                   "content": hent_status(**b.input)}
                  for b in svar.content if b.type == "tool_use"]
    messages.append({"role": "user", "content": resultater})
import anthropic, requests
client = anthropic.Anthropic()
# 1 · The tool: an ordinary function
def get_status(url):
try: return str(requests.get(url, timeout=5).status_code)
except Exception as e: return f"Error: {e}"
# ... described for the model: name, explanation, input format
tools = [{"name": "get_status",
"description": "Fetches the HTTP status of a URL",
"input_schema": {"type": "object", "required": ["url"],
"properties": {"url": {"type": "string"}}}}]
# 2 · The goal, in plain language
messages = [{"role": "user",
"content": "Check whether https://example.dk responds."}]
# 3 · The stop condition: at most 10 passes through the loop
for step in range(10):
# 4 · Decide: the model picks a tool, or answers
reply = client.messages.create(model="claude-opus-5",
max_tokens=1024, tools=tools, messages=messages)
messages.append({"role": "assistant", "content": reply.content})
# 5 · Goal met: it stops asking for tools
if reply.stop_reason != "tool_use":
print(reply.content[0].text)
break
# 6 · Act and observe: run the tool, send the result back
results = [{"type": "tool_result", "tool_use_id": b.id,
"content": get_status(**b.input)}
for b in reply.content if b.type == "tool_use"]
messages.append({"role": "user", "content": results})Kilde: Anthropic, Claude API-dokumentation: Tool use · forenklet eksempel
 2 · Fra skakmotor til sprogmodel
Tidslinjen fra 1912 til i dag — og hvad der var nyt ved hvert skridt.
- 1912El Ajedrecista
- 1950–97Skakprogrammer
- 1966–72Shakey-robotten
- 1995Agent som begreb
- 2013–17Dyb forstærkningslæring
- 2017Transformer
- 2022ChatGPT
- 2022–23ReAct og værktøjskald
- 2024Computerbrug og MCP
- 2025–Kode- og arbejdsagenter
Tre epoker: håndkodet af mennesker → lærer selv → sprogmodel som hjerne.
Hvornår kom den første maskine, der tog sine egne valg?
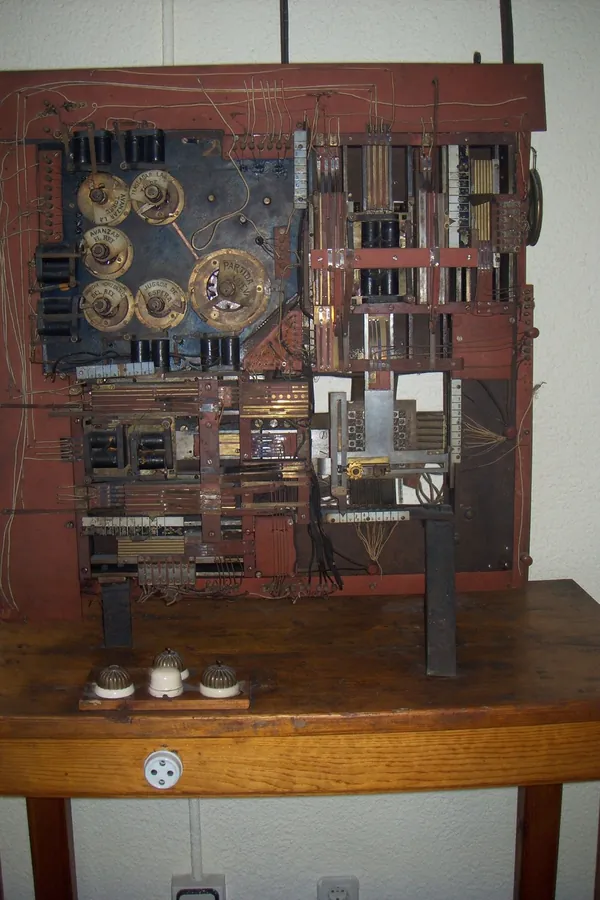
I 1912. Leonardo Torres Quevedos elektromekaniske automat El Ajedrecista spillede skakslutspillet konge og tårn mod konge.
Det nye var ikke intelligens, men at en maskine selv tog valg efter faste regler — uden en person til at vælge trækket.
Kilde: Torres Quevedo (1912)
Hvad kunne Deep Blue, der slog Kasparov i 1997?
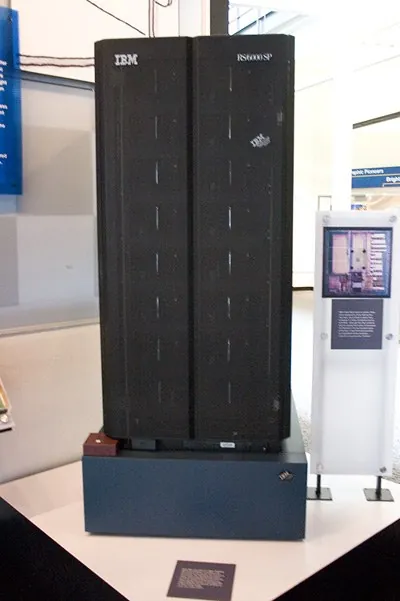
IBM's supercomputer gennemsøgte i gennemsnit omkring 100 millioner stillinger i sekundet og slog den regerende verdensmester. Det nye var, at råkraft kombineret med en håndkodet evalueringsfunktion kunne slå det bedste menneske.
Men al viden om skak var lagt ind af eksperter. Maskinen havde ikke lært noget selv.
Kilde: Campbell m.fl. (2002)
Hvornår blev »agent« et fagbegreb i AI?
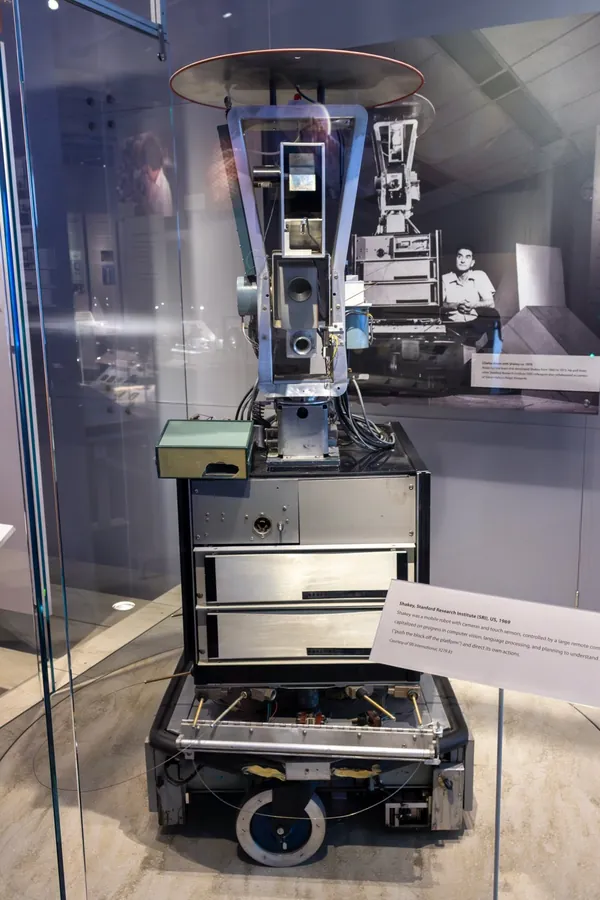
To skridt gjorde det. Fra 1966 til 1972 byggede SRI robotten Shakey — en mobil robot med kamera og berøringssensorer, styret af en fjern computer. Den sansede, planlagde og handlede i den virkelige verden.
I 1995 byggede Russell og Norvig hele AI-faget op omkring den intelligente agent i deres lærebog. Dermed fik faget en fælles definition: noget, der opfatter sit miljø og handler mod et mål.
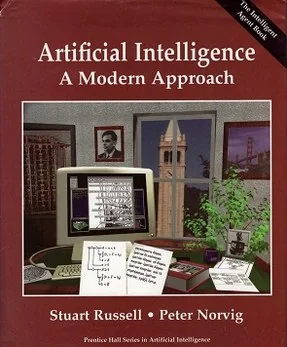
Kilder: Nilsson (1984); Russell og Norvig (1995)
Hvad var nyt ved DQN — agenten, der lærte selv?
DeepMinds Deep Q-Network fra 2013 lærte at spille 49 Atari-spil med samme program, kun ud fra skærmens pixels og spillets point. Det nåede menneskeligt niveau i cirka halvdelen af dem.
Q står for quality: et skøn over den samlede belønning, en handling vil give i en given situation. Netværket ser skærmen, giver hver mulig handling en Q-værdi og vælger den højeste. Spillet svarer med point, som netværket lærer af. Strategien er altså lært, ikke kodet.
Træk diagrammet til siden for at se det hele.
 Betydning
- Startede dyb forstærkningslæring.
- Banede vej for AlphaGo og AlphaZero.
- Strategien er lært, ikke kodet.
 Begrænsninger
- Trænes forfra for hvert spil.
- Kræver enorme mængder træning.
- Svag til langsigtet planlægning.
Kilder: Watkins (1989); Mnih m.fl. (2013, 2015)
Hvordan blev sprogmodellen agentens hjerne?
- 2017 · Transformer-arkitekturen
- En ny type netværk gør det muligt at træne modeller på enorme mængder tekst.
- 2022 · ChatGPT
- Generel sprogforståelse. Men en chatbot svarer kun — den handler ikke.
- 2022–23 · ReAct og værktøjskald
- Løkken lukkes: modellen tænker, kalder et værktøj, læser resultatet og fortsætter.
- 2024 – i dag · Computerbrug og kodeagenter
- Agenten betjener hele computeren og arbejder i timevis på én opgave.
Kilder: Vaswani m.fl. (2017); Yao m.fl. (2022); Anthropic (2024)
3 · Hvad er nyt, og hvor hurtigt går det?
Forskellene, hvor lange opgaver agenter klarer, og væksten på GitHub.
Hvad adskiller en LLM-agent fra Deep Blue og AlphaZero?
| Deep Blue, 1997 | AlphaZero, 2017 | LLM-agent, i dag | |
|---|---|---|---|
| Viden | Håndkodet af eksperter | Lært ved selvspil | Lært fra tekst og kode |
| Miljø | Lukket bræt, kendte regler | Lukket spil, kendte regler | Åben verden: computer og net |
| Mål | Altid det samme: vind | Altid det samme: vind | Nyt mål hver gang, i sprog |
| Bredde | Én opgave | Én type opgave | Næsten alle opgaver |
| Forudsigelighed | Laver aldrig ulovlige træk | Høj inden for spillet | Kan fejle på uforudsete måder |
Træk tabellen til siden for at se alle kolonner.
Fremhævet: væsentlig ændring fra forrige kolonne.
Generalitet er købt med lavere forudsigelighed. Det er roden til dagens dilemmaer.
Kilder: Campbell m.fl. (2002); Silver m.fl. (2018)
Hvor lange opgaver kan AI-agenter klare?
2 sek → 16 t
Træk diagrammet til siden for at se det hele.
METR måler agenters tidshorisont på softwareopgaver: hvor lang en opgave de kan gennemføre med 50 procents sikkerhed. Den er vokset fra sekunder til omkring 16 timer og er fordoblet cirka hver syvende måned siden 2019 — hurtigere siden 2024.
To forbehold er vigtige: kræver man 80 procents sikkerhed i stedet for 50, er horisonten 5 til 10 gange kortere. Og METR kan ikke længere måle sikkert over cirka 16 timer.
Kilder: Kwa m.fl. (2025); METR, Time Horizon 1.0 og 1.1 · afrundede værdier
Hvor er udviklingen på vej hen?
Holder tendensen, er opgaver på længden af en arbejdsuge — omkring 40 timer — inden for rækkevidde i 2026 til 2027.
Men det er en fremskrivning af en kurve, ikke en forudsigelse. Netop hvor hurtigt evnerne vil vokse, er et af de punkter, hvor der er reel faglig uenighed.
Kan man se udviklingen andre steder end i modellerne selv?
Ja, i aktiviteten på GitHub:
- 180 mio.udviklere i 2025, 60 gange flere end i 2013.
- 1 pr. sekundOver 36 mio. nye udviklere kom til i 2025 alene.
- × 19.000flere projekter: fra ca. 33.000 i 2008 til 630 mio. i 2025.
- 121 mio.nye projekter i 2025 — den årlige tilvækst er fordoblet siden 2020.
AI-værktøjer sænker tærsklen for at skrive kode. GitHub kobler selv springet i nye brugere sammen med Copilot Free, der kom i slutningen af 2024.
Kilder: GitHub Octoverse 2017–2025; GitHub-blog (2013, 2018)
 4 · Dagens dilemmaer
Pålidelighed, kontrol, sikkerhed, ansvar og frygt.
Hvorfor er lange opgaver meget sværere end korte?
Fordi små fejl forstærkes. En opgave på 50 skridt, hvor hvert skridt lykkes med 99 procents sikkerhed, er kun fejlfri i 61 procent af tilfældene. Hæver man skridt-sikkerheden til 99,9 procent, stiger det til 95 procent.
Jo længere opgaver agenter klarer, jo flere skridt tager de — og jo flere chancer er der for, at noget går skævt. Derfor flytter man mere ved at hæve pålideligheden pr. skridt end ved at bede om længere opgaver.
Træk diagrammet til siden for at se det hele.
Kilde: egen beregning, 0,99^50 ≈ 0,61 og 0,999^50 ≈ 0,95. Antager uafhængige skridt.
Hvor kommer en agents fejl fra?
- Hallucination: modellen finder på noget.
- Et værktøjsresultat bliver misforstået.
- Forkert værktøj eller forkert input til det rigtige værktøj.
- Selve målet bliver misforstået.
- Manipulation via det indhold, agenten læser.
- Opgaven erklæres løst for tidligt.
Hvor meget kontrol beholder mennesket?
Human in the loop
Mennesket godkender hver handling, før den udføres.
Human on the loop
Agenten handler selv. Mennesket overvåger og kan gribe ind.
Human out of the loop
Agenten handler uden løbende tilsyn.
Begreberne kommer fra styringssystemer og debatten om autonome våben. Valget afhænger typisk af, hvor kritisk og hvor reversibel handlingen er.
Hvad er prompt injection?
En agent læser websider, mails og dokumenter. Det indhold kan rumme skjulte instruktioner, der forsøger at overtage agentens opgave. Det kaldes prompt injection og står som nummer ét på OWASP's liste over risici ved LLM-applikationer.
Problemet er bredt anerkendt og ikke løst. I praksis håndteres det ikke ved at gøre modellen klogere, men ved at begrænse rettigheder og køre agenten i en sandkasse, så en overtagelse ikke kan nå noget vigtigt.
Kilde: OWASP Top 10 for LLM Applications, LLM01: Prompt Injection
Hvem bærer ansvaret, når en agent handler forkert?
Ansvaret er delt mellem udvikler, udbyder og bruger, og fordelingen afhænger af konteksten. EU's AI-forordning (forordning 2024/1689) indfases gradvist og stiller krav efter risiko, men mange konkrete agent-spørgsmål er endnu uafklarede.
Derfor er logning og sporbarhed ikke kun en teknisk detalje. Det er dokumentationen af, hvad der faktisk skete.
Hvad er der faglig enighed om, og hvad er reelt omdiskuteret?
 Bred enighed
- Agenter kan fejle på måder, ingen har forudset.
- Manipulation via indhold er et reelt problem.
- Irreversible handlinger bør kræve godkendelse.
- Mere autonomi kræver test, logning og sporbarhed.
 Reel uenighed
- Hvor hurtigt evnerne vil vokse.
- Om avancerede systemer kan blive svære at kontrollere.
- Hvor stor betydningen bliver for arbejdsmarkedet.
- Om regulering bremser udviklingen eller er en forudsætning for den.
 5 · Konklusion og praksis
Hvad er den korte konklusion?
Autonomi er en skala, ikke et enten-eller.
Jo mere kritisk og irreversibel en handling er, jo tættere bør den menneskelige kontrol være. Frygt og begejstring handler ofte om forskellige tidshorisonter: de nære risici er konkrete og kan håndteres med kendte principper, mens de langsigtede er reelt omdiskuterede.
Hvad betyder det, hvis man vil sætte en agent i drift?
- Start med opgaver, der er reversible, så en fejl kan rulles tilbage.
- Giv agenten de mindst mulige rettigheder, og kør den i en sandkasse.
- Sæt stopbetingelser, så den ikke kan køre i ring.
- Log hvert skridt, så man bagefter kan se, hvad der skete, og hvorfor.
- Kræv godkendelse før irreversible handlinger.
- Mål fejl pr. skridt frem for at vurdere agenten på en god demo.
Det er præcis den slags arbejde, jeg laver: ikke prototypen, men det lag af rammer, logning og integration, der gør, at en agent kan stå i drift.
 Forkortelser
| AI | Artificial Intelligence | kunstig intelligens |
|---|---|---|
| API | Application Programming Interface | grænseflade mellem programmer og tjenester |
| DQN | Deep Q-Network | DeepMinds selvlærende spilagent fra 2013 |
| GPT | Generative Pre-trained Transformer | OpenAIs familie af sprogmodeller |
| LLM | Large Language Model | stor sprogmodel, fx GPT eller Claude |
| MCP | Model Context Protocol | fælles standard for at koble værktøjer til AI-modeller |
| METR | Model Evaluation and Threat Research | nonprofitorganisation, der måler AI-modellers evner |
| OWASP | Open Worldwide Application Security Project | nonprofitorganisation for softwaresikkerhed |
| ReAct | Reasoning and Acting | metode, hvor modellen skiftevis tænker og handler |
| SRI | Stanford Research Institute | nu SRI International, byggede Shakey |
Kilder
Alle tal og påstande på siden kan føres tilbage hertil.
Historie
- Torres Quevedo, L. (1912). El Ajedrecista. en.wikipedia.org
- Shannon, C. E. (1950). Programming a Computer for Playing Chess. Philosophical Magazine, 41(314). doi.org
- Nilsson, N. J. (red.) (1984). Shakey the Robot. SRI International, Technical Note 323. ai.stanford.edu
- Russell, S. og Norvig, P. (1995). Artificial Intelligence: A Modern Approach. Prentice Hall. aima.cs.berkeley.edu
- Campbell, M., Hoane, A. J. og Hsu, F. (2002). Deep Blue. Artificial Intelligence, 134(1–2). doi.org
Lærende AI
- Watkins, C. J. C. H. (1989). Learning from Delayed Rewards. Ph.d.-afhandling, University of Cambridge. cs.rhul.ac.uk
- Mnih, V. m.fl. (2013). Playing Atari with Deep Reinforcement Learning. arXiv:1312.5602. arxiv.org
- Mnih, V. m.fl. (2015). Human-level control through deep reinforcement learning. Nature, 518. doi.org
- Silver, D. m.fl. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529. doi.org
- Silver, D. m.fl. (2018). A general reinforcement learning algorithm that masters chess, shogi and Go through self-play. Science, 362. doi.org
Sprogmodeller og agenter
- Vaswani, A. m.fl. (2017). Attention Is All You Need. arxiv.org
- Yao, S. m.fl. (2022). ReAct: Synergizing Reasoning and Acting in Language Models. arxiv.org
- Anthropic (2024). Introducing computer use. anthropic.com
- Anthropic (2024). Introducing the Model Context Protocol. anthropic.com
- Anthropic. Tool use with Claude. platform.claude.com
- Kwa, T. m.fl. (2025). Measuring AI Ability to Complete Long Tasks. METR. arxiv.org
- METR (2026). Time Horizon 1.1. metr.org
GitHub
- GitHub (2013). Three Million Users. github.blog
- GitHub (2018). Thank you for 100 million repositories. github.blog
- GitHub (2017–2025). The State of the Octoverse, årlige rapporter. octoverse.github.com
- GitHub (2025). Octoverse 2025. github.blog
Billeder
- El Ajedrecista. Wikimedia Commons — se filen for fotograf og licens. commons.wikimedia.org
- Deep Blue. Wikimedia Commons — se filen for fotograf og licens. commons.wikimedia.org
- Shakey. Wikimedia Commons — se filen for fotograf og licens. commons.wikimedia.org
- Forside: Russell og Norvig (1995), Prentice Hall. Ophavsretligt beskyttet. aima.cs.berkeley.edu
Dilemmaer og regulering
- Scharre, P. (2018). Army of None: Autonomous Weapons and the Future of War. W. W. Norton. publishersweekly.com
- OWASP (2025). Top 10 for LLM Applications, LLM01: Prompt Injection. genai.owasp.org
- Forordning (EU) 2024/1689 af 13. juni 2024 om kunstig intelligens. eur-lex.europa.eu